uniq
Entfernt oder zählt wiederholte Zeilen, die direkt aufeinanderfolgen.
Syntax
uniq [OPTION]... [EINGABE [AUSGABE]]
Optionen
| Option | Beschreibung |
|---|---|
-c, --count |
Anzahl der Vorkommen vor jede Zeile setzen |
-d, --repeated |
Nur Zeilen zeigen, die mehrfach vorkommen |
-u, --unique |
Nur Zeilen zeigen, die genau einmal vorkommen |
-i, --ignore-case |
Groß- und Kleinschreibung ignorieren |
-f N, --skip-fields=N |
Die ersten N Felder beim Vergleich ignorieren |
Beispiele
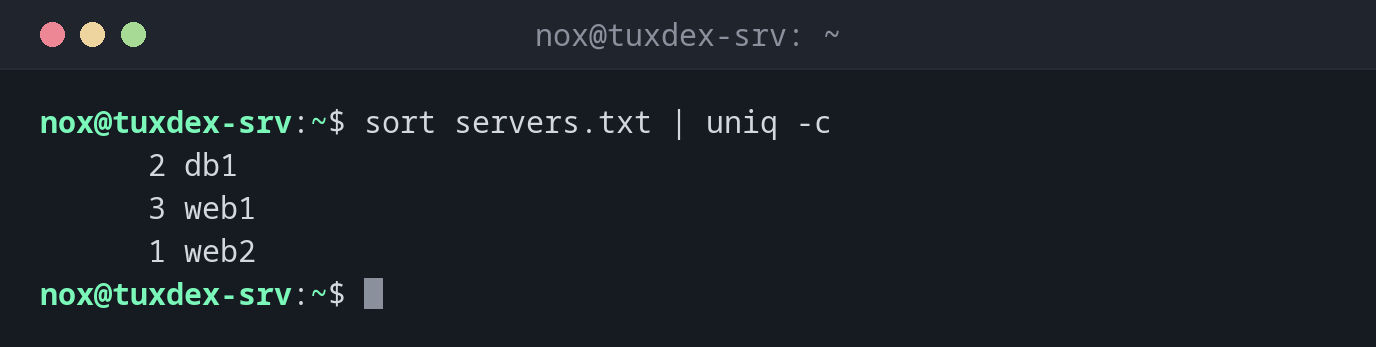
Zählen, wie oft jede Zeile vorkommt:
sort servers.txt | uniq -c
      2 db1
      3 web1
      1 web2
Die HTTP-Statuscodes in einem Log zählen:
cut -d' ' -f9 /var/log/nginx/access.log | sort | uniq -c
      5 200
      1 302
      3 404
Die IP-Adressen mit den meisten Anfragen finden:
cut -d' ' -f1 /var/log/nginx/access.log | sort | uniq -c | sort -rn
      4 198.51.100.23
      2 192.0.2.77
      2 192.0.2.10
      1 192.0.2.55
Nur Zeilen zeigen, die mehrfach vorkommen:
sort servers.txt | uniq -d
db1
web1
uniq ohne sort:
uniq servers.txt
web1
db1
web2
web1
db1
web1
Nichts wurde entfernt, weil die Duplikate in der Datei nicht direkt nebeneinander stehen.
Wann brauche ich das?
- Um zu zählen, wie oft etwas in einem Log vorkommt: IP-Adressen, Statuscodes, URLs, Fehlermeldungen
- Um Duplikate in Listen zu finden, etwa doppelte Einträge in einer Benutzer- oder Hostliste
- Um eine Liste auf ihre eindeutigen Einträge zu kürzen
Die klassische Pipeline
sort | uniq -c | sort -rn ist eine der nützlichsten Befehlsketten: Sie zählt alle
Werte und setzt die häufigsten nach oben. Mit | head dahinter bekommst du eine Top 10.
Immer zuerst sortieren
uniq vergleicht eine Zeile nur mit der direkt davor. Duplikate, die über die Datei
verteilt sind, findet es erst nach sort.